Las comunidades de física y ciencias de la vida de Europa están avanzando hacia una nueva era de computación a escala extrema: sistemas de clase exaescala, IA de billones de parámetros, instrumentos con gran demanda de datos y flujos de trabajo que combinan simulación, análisis e IA en el mismo trabajo. Aquí está la dura verdad que la mayoría solo admite después de una brutal primera prueba de escala: la red es el cuello de botella, no las GPU, no el almacenamiento, ni siquiera la CPU.
Ahí es donde el diseño y la entrega de la solución HPC de Cornelis CN5000 Omni-Path® y Hammer encajan: una red diseñada para mantenerse predecible bajo carga pesada, combinada con un enfoque que ayuda a las organizaciones europeas a diseñar, validar, implementar y soportar la arquitectura que se adapta a sus aplicaciones.
Qué ha cambiado en la informática de investigación europea y por qué la red importa más que nunca
La física y las ciencias de la vida están enfrentando puntos de presión similares:
- Colectivos MPI a gran escala (allreduce/alltoall), sensibles a la latencia de cola
- Muchos mensajes pequeños donde la tasa de mensajes importa tanto como el ancho de banda
- Tráfico incast y ráfagas (común en entrenamiento de IA, reconstrucción y barajados de analítica)
- Simulación con mucha sincronización donde la fluctuación se convierte en tiempo de cómputo desperdiciado
Cuando una interconexión se congestiona o introduce retrasos de cola larga, se observa un colapso de la utilización: aceleradores costosos inactivos, esperando el siguiente lote o colectivo para completarse.
CN5000 en términos sencillos: qué es y para qué está diseñado
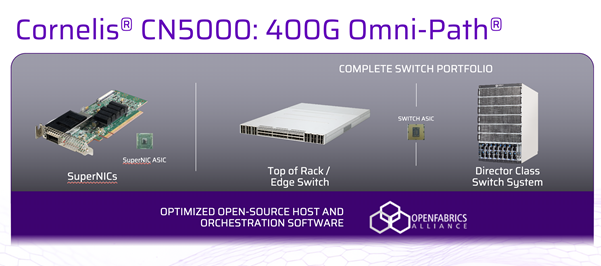
Cornelis CN5000 Omni-Path es una plataforma de red escalable orientada a entornos de IA y HPC donde se requiere alto rendimiento y rendimiento estable, incluso cuando el sistema está ocupado.
Algunos puntos prácticos que importan para los equipos de HPC:
- Conmutación de 400G por puerto (los conmutadores CN5000 se referencian comúnmente como clase 400G de 48 puertos, ofreciendo un ancho de banda agregado muy alto por conmutador)
- Capacidad de procesamiento de paquetes muy alta (crítica para el tráfico HPC de mensajes pequeños)
- Un enfoque de diseño para evitar caídas de rendimiento mediante comportamiento sin pérdidas, gestión de congestión de la red, enrutamiento multipath y control de flujo robusto
La idea central: mantener la comunicación predecible cuando el clúster está lleno de trabajos reales, no solo al ejecutar pruebas idealizadas en una red tranquila.
Dónde encaja Hammer al convertir la capacidad del CN5000 en una solución europea desplegable
CN5000 es la tecnología de red. El valor de Hammer es hacer que funcione en el mundo real: equilibrando los objetivos de rendimiento con las restricciones de adquisición, los plazos, los estándares del sitio y la preparación operativa.
En la práctica, eso generalmente significa:
- Traducir las necesidades de las aplicaciones (MPI, entrenamiento de IA, análisis de pipelines) en un diseño de tejido escalable
- -Validar el rendimiento con las pruebas adecuadas (no solo los benchmarks predeterminados del proveedor
- Entregando una solución integrada:
- Conmutación
- Cableado
- Conectividad del host
- Configuración
- Soporte de implementación
- Ayudando a los equipos a operativizar:
- Monitoreo
- Control de cambios
- Estrategia de repuestos
- Patrones de soporte del segundo día
Tabla comparativa: CN5000 vs enfoques comunes de interconexión HPC/IA
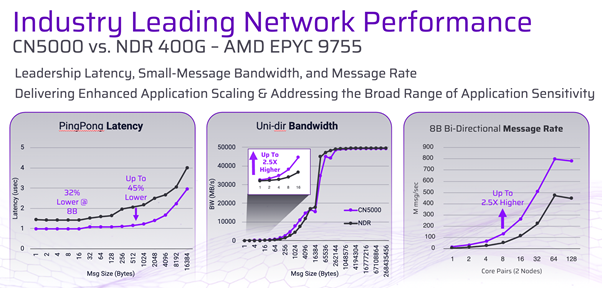
La interconexión “mejor” depende de la carga de trabajo, la escala y las preferencias operativas. La tabla siguiente es una comparación práctica a nivel de arquitectura que puede utilizar en debates de diseño en fase inicial.
|
Criterio |
Cornelis CN5000 Omni-Path |
InfiniBand (generaciones modernas) |
Ethernet (RoCE / Ethernet de alto rendimiento) |
|
Objetivo principal de diseño |
Escalado horizontal de IA + HPC con tiempos de finalización predecibles bajo carga |
Escalado HPC/AI, ampliamente adoptado en HPC de gama alta |
Centro de datos amplio + AI/HPC donde la alineación de estándares y las herramientas comunes son clave |
|
Behaviour under congestion |
Diseñado para minimizar el impacto de la congestión y mantener un rendimiento estable (intención de red sin pérdidas) |
Opciones sólidas según la configuración y el control de congestión |
Puede ser excelente, pero tiende a ser más sensible a un ajuste correcto (PFC/ECN, buffering, QoS) |
|
Sensibilidad a la latencia de cola |
Generalmente optimizado para baja latencia y tasa de mensajes |
En general, muy fuerte para baja latencia y colectivos |
Puede ser competitivo, pero la latencia de cola puede degradarse si se configura mal o se sobresuscribe |
|
Complejidad operativa |
Herramientas y modelos centrados en HPC; típicamente, más “fabric-first” |
Ecosistema maduro; patrones operativos sólidos en HPC |
Familiar para los equipos de red, pero “RoCE de grado HPC” generalmente exige una disciplina de diseño cuidadosa |
|
Ecosistema e integración |
Diseñado para stacks de HPC/IA; la integración depende de las elecciones de plataforma |
Soporte muy amplio del ecosistema HPC |
Ecosistema de proveedores/herramientas más amplio en general |
|
Punto óptimo típico |
Colectivos ajustados, HPC con alta tasa de mensajes, clústeres mixtos de IA/HPC donde la previsibilidad es la prioridad |
Implementaciones muy grandes de HPC/AI con prácticas IB establecidas |
Sitios que estandarizan en Ethernet, cargas de trabajo mixtas, o que buscan un modelo operativo de red unificado |
|
Riesgo común si se elige mal |
Validación con alcance insuficiente (no probar patrones de carga de trabajo reales desde el principio) |
Planificación de costos/disponibilidad; las decisiones de diseño importan a escala |
“Es Ethernet, estará bien”, hasta que aparecen tormentas PFC, brechas de QoS o vecinos ruidosos |
Si quieres una regla general contundente: la HPC y la IA científica no solo necesitan enlaces rápidos; necesitan una estructura que se mantenga estable cuando todos se comunican a la vez.
Un plan práctico: implementar CN5000 para física y ciencias de la vida europeas
1) Comience con el perfil de comunicación (no con el número de puertos)
Haz preguntas como:
- ¿Estamos dominados por colectivos (allreduce/alltoall)?
- ¿Estamos limitados por la tasa de mensajes (muchos mensajes pequeños)?
- ¿Vemos caídas de rendimiento cuando el sistema está ocupado?
- ¿Están las GPUs esperando por sincronización?
Esto determina si debe optimizar para ancho de banda, latencia, comportamiento de cola o un enfoque equilibrado.
2) Diseñar para etapas de escalado, no para una única instantánea
Muchas organizaciones europeas escalan por fases:
- Prueba de valor a escala de pod o rack
- Producción multi-rack
- Crecimiento multi-clúster o federado
Un diseño de tejido CN5000 debe reflejar eso desde el primer día, incluyendo topología, estrategia de cableado, puertos de crecimiento y límites operativos.
3) Validar con ciencia real No te detengas en microbenchmarks. Incluye:
- Colectivos MPI a la escala prevista
- Mini-aplicaciones y kernels representativos
- Pruebas de comunicaciones de entrenamiento de IA (pasos con mucha operación colectiva)
- Pruebas de estrés multi-tenant si ejecutas infraestructura compartida
El objetivo es detectar temprano las “victorias de laboratorio silencioso” frente a las “victorias de la realidad de producción”, mientras los cambios aún son económicos.4) Operacionalizar temprano (porque el día 2 es donde los proyectos triunfan o mueren)
Planifique para:
- Telemetría y paneles (latencia, señales de congestión, errores de enlace, puntos calientes)
- Gestión de cambios (firmware, desviación de configuración, despliegue controlado)
- Planificación de repuestos y resiliencia
Aquí es donde el enfoque de entrega y soporte de Hammer’s puede cerrar la brecha entre una red rápida y un servicio manejable.
Patrones de arquitectura de referencia para laboratorios e institutos de investigación europeos
Aquí hay tres patrones comunes que funcionan bien al construir alrededor de CN5000 para entornos de física y ciencias de la vida
Patrón A: “Pódcast científico” para adopción rápida
- 1–2 racks de cómputo (CPU o GPU)
- Conmutación de hoja CN5000 dedicada
- Límites claros de entrada/salida hacia el almacenamiento y la red del campus más amplia
- Ideal para demostrar ganancias reales de carga de trabajo y capacitar a los equipos de operaciones
Patrón B: Clúster de producción mixto de IA + HPC
- Particiones lógicas o colas separadas para:
- Entrenamiento de IA
- Simulación
- Pipelines de datos
- Fabric diseñado para evitar impactos de vecinos ruidosos durante ejecuciones de entrenamiento pico
- Énfasis en colectivos predecibles y tiempos de finalización de trabajos estables
Patrón C: Crecimiento multi-clúster con servicios compartidos
- Múltiples clústeres respaldados por CN5000 (por ejemplo, imágenes de ciencias de la vida, simulación de física)
- Servicios compartidos:
- Autenticación
- Política de programación
- Monitoreo
- Almacenamiento
- La estrategia del fabric se centra en la repetibilidad: “Podemos implementar esto nuevamente con confianza.”
No existe un diseño “correcto” único: se trata de que puedas alinear la topología y el modelo operativo con cómo funciona realmente tu organización.
Gobernanza de datos, seguridad y colaboración en toda Europa
La física y las ciencias de la vida a menudo se encuentran en extremos opuestos del espectro de gobernanza de datos – desde datos experimentales relativamente abiertos en algunos dominios de la física, hasta datos humanos altamente sensibles en partes de las ciencias de la vida. El diseño moderno de redes HPC debe reconocer esa realidad.
Al implementar infraestructura basada en CN5000 en entornos europeos, es esencial incorporar
- Segmentación por diseño (proyectos, inquilinos, conjuntos de datos regulados)
- Control de cambios auditable (quién cambió qué, cuándo y por qué)
- Límites claros hacia el almacenamiento y las redes externas (minimizar rutas de datos sorpresivas)
- Preparación para la colaboración (soporte para modelos de acceso federado, cuando corresponda
Nada de esto es llamativo, pero a menudo es la diferencia entre “un clúster rápido” y “una plataforma en la que la organización puede confiar durante los próximos cinco años”.
Casos de uso comunes donde la entrega de CN5000 + Hammer puede marcar la diferencia
Entrenamiento de IA para modelos científicos
- Los colectivos, los puntos de sincronización y los patrones de ráfaga dominan
- La previsibilidad bajo carga es lo que mejora el tiempo hasta los resultados
Simulación a gran escala con puntos de sincronización
- La latencia de cola y la fluctuación pueden afectar gravemente a la simulación de física estrechamente acoplada
- La capacidad de tasa de mensajes y el comportamiento estable son importantes
Pipelines de imágenes, reconstrucción y multi-ómicas
- Los flujos de trabajo combinan etapas intensivas en ancho de banda y barajados intensivos en comunicación
- A menudo se ejecutan de forma concurrente en múltiples equipos
Preguntas frecuentes: Cómo ayuda CN5000 Omni-Path en clústeres reales de HPC + IA
¿Cómo mejora Cornelis CN5000 Omni-Path el rendimiento de HPC e IA en clústeres reales?
En clústeres de producción, el rendimiento a menudo no es el limitador; la congestión y la latencia de cola larga lo son. CN5000 está diseñado para mantener la comunicación predecible bajo carga, para que los trabajos no encuentren “acantilados de rendimiento” cuando muchos inquilinos o muchos rangos se comunican a la vez.
En la práctica, esto proviene de un diseño Omni-Path que enfatiza:
- Comportamiento sin pérdidas con control de flujo basado en créditos (para que no caigas en espirales de pérdida/retransmisión bajo presión).
- Enrutamiento adaptativo de grano fino / multipath para sortear puntos calientes transitorios.
- Gestión activa de congestión (a menudo descrita como ritmo/desaceleración informada por el conmutador) para reducir los efectos de cola.
El efecto neto: menos paradas en fases de colectivos y sincronización, y mejor utilización del acelerador cuando la red está ocupada.
¿Qué tipos de cargas de trabajo se benefician más de CN5000 en física y ciencias de la vida?
CN5000 tiende a mostrar su mejor rendimiento cuando la fluctuación y la latencia de cola dominan los resultados, especialmente:
- Colectivas MPI ajustadas (p. ej., allreduce/alltoall) a escala
- Aplicaciones de alta tasa de mensajes con muchos mensajes pequeños
- Simulaciones con mucha sincronización donde unos pocos rangos lentos arrastran el paso de tiempo
- Tráfico ráfaga o con alta carga de incast observado en entrenamiento de IA multinodo, pipelines de reconstrucción y análisis con mucha reorganización de datos
Si su perfilado muestra un aumento de tiempo en colectivas, barreras o intercambios de halo a medida que escala, esta es la clase de problema que CN5000 está diseñado para abordar.
¿Por qué la red se convierte en el cuello de botella antes que las GPU o el almacenamiento a escala?
A medida que los clústeres escalan, se dedica más tiempo de pared a la coordinación (gradientes, reducciones, intercambios, barreras). Cuando aparecen congestiones o retrasos de cola larga, los nodos y GPUs más rápidos terminan esperando los eventos de comunicación más lentos. La utilización puede colapsar incluso si el “ancho de banda máximo” parece fuerte en el papel.
¿Qué significa “Lossless” en la práctica? En la práctica, “lossless” se trata de evitar la pérdida de paquetes y la retransmisión que amplifican la congestión y crean picos de latencia. Estos picos se manifiestan como colectivos lentos y tiempos de finalización de trabajos impredecibles.
CN5000 está posicionado en torno a la transmisión sin pérdidas y sin congestión, utilizando control de flujo basado en créditos y enrutamiento adaptativo para mantener la estabilidad bajo carga mixta.
¿En qué se diferencia CN5000 de InfiniBand o Ethernet de alto rendimiento (RoCE)?
A alto nivel:
- CN5000 (Omni-Path): Posicionado como una estructura de escalado horizontal de extremo a extremo optimizada para un rendimiento predecible bajo carga, aprovechando el comportamiento sin pérdidas, el enrutamiento adaptativo y el control de congestión como objetivos de diseño de primera clase.
- InfiniBand: ampliamente implementado en HPC de gama alta con un ecosistema profundo y prácticas operativas maduras (rendimiento excelente, amplio soporte de proveedores).
- RoCE / Ethernet de alto rendimiento: Familiar operativamente y capaz de ofrecer un rendimiento sólido, pero normalmente requiere disciplina en el diseño de PFC/ECN, buffering, QoS y control de vecinos ruidosos para evitar sorpresas de latencia de cola a escala.
También vale la pena decirlo claramente: los “beneficios completos” del CN5000 se describen típicamente como provenientes de una solución Omni-Path de extremo a extremo (Switches + NICs) en lugar de mezclar y combinar en la ruta de datos.
¿Qué entrega realmente Hammer en un proyecto de HPC basado en CN5000?
Hammer convierte la interconexión en algo que puedes operar día a día, cubriendo típicamente:
- Requisitos → diseño de la red: (topología, objetivos de sobresuscripción, plan de crecimiento, estrategia de cableado)
- Validación: planes de prueba que reflejen cargas de trabajo reales (no solo microbenchmarks de laboratorio silencioso)
- Construcción y despliegue: switches, ópticas/cables, conectividad de hosts, plantillas de configuración, soporte de migración
- Operaciones: expectativas de monitoreo/telemetría, control de cambios, estrategia de repuestos y runbooks de soporte
¿Cómo deberíamos validar una estructura CN5000 antes de comprometernos con un despliegue completo?
Una validación práctica previa al despliegue generalmente incluye:
- Pruebas colectivas de MPI a la escala prevista (no solo en un solo rack)
- Mini-aplicaciones / kernels representativos de su base de usuarios real
- Pruebas de comunicación de IA que estresan pasos con alta carga colectiva (y patrones de solapamiento)
- Pruebas de estrés de múltiples inquilinos para revelar efectos de vecino ruidoso y comportamiento de cola larga
El objetivo: detectar casos donde los “triunfos de laboratorio silencioso” no se traducen a producción—mientras que los cambios de topología y políticas aún son económicos.
¿Cómo diseñamos una red CN5000 para un crecimiento por fases en los sitios de investigación europeos?
Muchos programas escalan en fases (pod → multi-rack → multi-clúster/federación). Movimientos de diseño comunes que mantienen el crecimiento sin dolor:
- Elija una topología con una ruta de expansión clara (puertos reservados para crecimiento, cableado predecible)
- Defina los límites operativos desde el principio (inquilinos/particiones/colas, expectativas de QoS)
- Planifique cómo manejará el control de cambios y el “radio de explosión” al añadir racks o sitios
De esa manera, la escalabilidad no introduce accidentalmente nuevos puntos críticos o comportamiento de vecino ruidoso
¿Cómo pueden las implementaciones de CN5000 respaldar la gobernanza de datos y la seguridad en toda Europa?
En entornos regulados de ciencias de la vida, la red es parte del plano de control para la gobernanza. Los patrones típicos incluyen:
- Segmentación por proyecto/inquilino (para que los conjuntos de datos regulados no compartan rutas inesperadas)
- Configuración auditable + control de cambios alineado con su modelo de seguridad
- Límites claros hacia el almacenamiento y las redes externas para evitar rutas accidentales de salida de datos
- Donde se necesita colaboración, patrones de acceso federados deliberados en lugar de interconexión ad-hoc
Conclusiones clave para los líderes de investigación europeos
- La red es cada vez más el factor decisivo para el rendimiento real en física y ciencias de la vida, especialmente con cargas de trabajo mixtas de IA + HPC.
- Cornelis CN5000 apunta a un rendimiento predecible a escala, donde el comportamiento de congestión y la latencia de cola a menudo dominan el tiempo de finalización del trabajo.
- Hammer ayuda a traducir esa capacidad en una solución europea funcional:
- Diseñado
- Validado
- Desplegado
Operable como servicio– no solo una colección de componentes de alto rendimiento Contacte a nuestros expertos hoy para hablar sobre las soluciones de Cornelis Networks
¿Quiere saber más?