La fabricación inteligente en Europa ha ido mucho más allá de los PLC más paneles de control. Hoy incluye inspección por visión artificial, optimización impulsada por IA, gemelos digitales que requieren fidelidad en vivo, y clústeres periféricos que deben comportarse como mini centros de datos, de manera fiable, todos los días.
En esa realidad, el dolor de escalado más común a menudo no es el modelo ni la GPU. Es la red: congestión, jitter y pérdida de paquetes que aparecen exactamente cuando añades la siguiente línea, el siguiente conjunto de cámaras o el siguiente pipeline de analítica.
Ahí es donde una capacidad muy específica se vuelve central: Cornelis CN5000 Omni-Path®, posicionado por Cornelis como "la primera red de escalado horizontal sin pérdidas y sin congestión del mundo" - combinado con Hammer Distribution para hacer que el diseño, el suministro y el despliegue liderado por socios sean viables en toda Europa.[RM1]
Por qué la IA de fábrica estresa las redes de manera diferente
Los patrones de datos industriales pueden ser un poco… bruscos. A menudo se ve:
- Flujos de visión de alta velocidad que alimentan nodos de inferencia y almacenamiento simultáneamente
- Momentos “incast” ráfaga cuando muchos dispositivos reportan juntos (alarmas, eventos por lotes, estadísticas de fin de ciclo)
- Tráfico este-oeste entre nodos para análisis, extracción de características y simulación
- Una mezcla de flujos de tiempo real estricto (control de inspección, coordinación robótica) junto con tráfico menos crítico
En redes de mejor esfuerzo, las microexplosiones y la presión de colas pueden provocar pérdidas de paquetes y retransmisiones, una ruta común hacia picos de latencia de cola. (Por eso los diseños de “Ethernet sin pérdidas” para RDMA suelen apoyarse en mecanismos como PFC y ECN/DCQCN, con un ajuste cuidadoso a lo largo de la ruta.)
La estructura de expansión sin pérdidas y sin congestión de CN5000
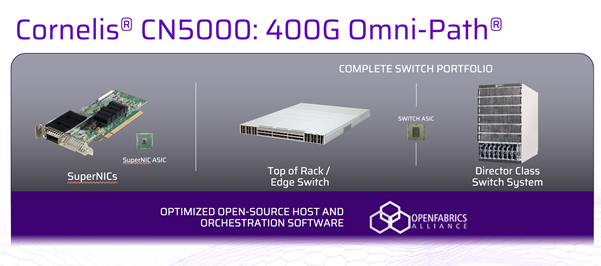
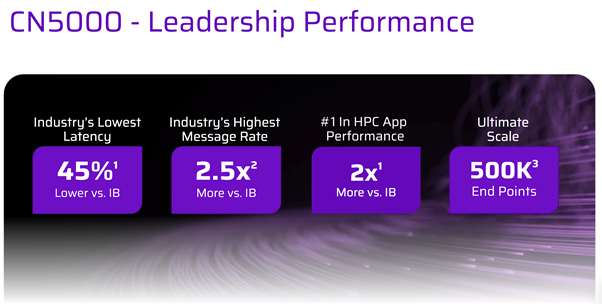
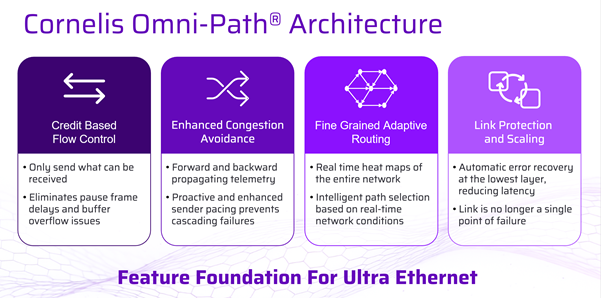
Cornelis describe CN5000 como una transmisión de datos sin pérdidas y sin congestión mediante control de flujo basado en créditos y enrutamiento adaptativo dinámico de grano fino, diseñado para mantener el rendimiento y la latencia predecibles a medida que aumentan las cargas.
Una forma útil de plantearlo para los fabricantes:
El CN5000 no intenta “lidiar” con la congestión después del hecho: está diseñado para prevenir pérdidas y gestionar la congestión de manera conductual a través de la red.
Los materiales del conmutador clase Director CN5000 de Cornelis también destacan la telemetría de grano fino y el análisis de tráfico en tiempo real para detectar congestión y optimizar el rendimiento, además de puntos de escala de alta densidad, como hasta 576 puertos de 400G en la plataforma de clase director.
Comparación: CN5000 Omni-Path vs enfoques de red comunes para clústeres de IA/edge en fábricas
|
Lo que le importa en la fabricación inteligente |
Cornelis CN5000 Omni-Path |
RoCEv2 sobre Ethernet (diseño Ethernet sin pérdidas) |
InfiniBand (implementaciones típicas) |
|
Objetivo principal de diseño |
Red de escalado horizontal sin pérdidas y sin congestión para patrones de tráfico de IA/HPC |
RDMA sobre Ethernet, normalmente diseñado para comportarse sin pérdidas para clases RDMA |
Comportamiento de tejido sin pérdidas con control de flujo basado en créditos (implementaciones comunes) |
|
Cómo se aborda la ausencia de pérdidas |
Control de flujo basado en créditos + comportamiento de congestión a nivel de red (descripción de Cornelis) |
A menudo mediante PFC + ECN/DCQCN (se requiere configuración y ajuste de extremo a extremo) |
Control de flujo de enlace basado en créditos para evitar pérdidas dentro de la estructura (característica típica) |
|
Gestión de congestión |
Enrutamiento adaptativo + comportamiento de tejido consciente de la congestión (descripción de Cornelis) |
Señalización de congestión y ajuste de velocidad estilo ECN/DCQCN; PFC como red de seguridad |
Mecanismos de tejido integrados y herramientas operativas maduras en muchos entornos HPC |
|
Énfasis operativo |
Eficiencia de escalado horizontal + análisis de telemetría/tráfico (Cornelis) |
Fuertemente dependiente de una configuración consistente de PFC/ECN a lo largo de la ruta |
A menudo se elige donde se prioriza el comportamiento determinista del tejido |
|
Por qué es importante en el borde de la fábrica |
Ayuda a mantener la latencia predecible cuando la visión + la analítica + la simulación coinciden en el mismo pod |
Puede funcionar bien, pero la ingeniería de “Ethernet sin pérdidas” se convierte en parte del alcance del proyecto |
Una opción conocida para redes sin pérdidas y de baja latencia (más típica en entornos HPC) |
El punto no es “solo hay una respuesta correcta.” Es que los clústeres de borde de manufactura inteligente se comportan como entornos de IA/HPC a escala reducida, y CN5000 está explícitamente posicionado para esos patrones de tráfico: sin pérdidas, con gestión de congestión y observable a escala.
Dónde encaja Hammer para convertir una tela en una solución europea desplegable
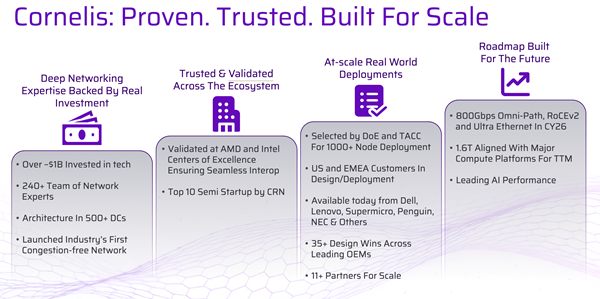
Los fabricantes rara vez compran “una red” de forma aislada. Compran un resultado entregado por un socio: un diseño validado, construcciones de rack integradas, logística que coincida con las ventanas de implementación y capacidad de soporte que no colapse durante el primer incidente.
Hammer se posiciona en torno a exactamente ese tipo de habilitación, incluyendo configuración a escala de rack interna, pruebas y logística, además de un enfoque de diseño consultivo.
La cobertura de la industria también describe la evolución de Hammer hacia una huella europea más amplia con oficinas e instalaciones adicionales que respaldan soluciones de centro de datos listas para usar.
Entonces, en un contexto de Cornelis, el papel de Hammer es el pragmático: ayudar al canal a entregar CN5000 de una manera que coincida con cómo la manufactura europea tiende a implementar proyectos: pod piloto → primera línea → primer sitio → repetibilidad multi-sitio.
Casos de uso que se asignan perfectamente al conjunto de funciones de CN5000
1) Pods de inspección por visión que no toleran fluctuaciones de rendimiento
La inspección de alta resolución crea un rendimiento sostenido más ráfagas (metadatos, escrituras de almacenamiento, disparadores de eventos). El comportamiento sin pérdidas y gestionado por congestión ayuda a reducir el efecto de “estaba bien hasta que añadimos dos cámaras más”.
2) Bucles de gemelos digitales que necesitan fidelidad en vivo
Un gemelo alimentado tarde se convierte en una herramienta de informes, no en una herramienta operativa. El posicionamiento de CN5000 en torno a la transmisión sin congestión más telemetría/análisis es directamente relevante cuando se necesitan flujos estables y observables en el borde.
3) Análisis de fábrica a escala - sin la frágil fase de red
A medida que se escala de una línea a muchas, la presión de ráfaga y el comportamiento de tipo incast se vuelven más comunes. Si la pérdida de paquetes comienza a impulsar retransmisiones y latencia de cola, la estabilidad se resiente. Una estructura diseñada para permanecer sin pérdidas bajo carga cambia la historia del escalado.
Arquitectura de referencia: un “pod de IA de fábrica” que escala
Un patrón simple y repetible que suele funcionar bien es el pod de IA de fábrica: un clúster perimetral autónomo que ejecuta los procesos en tiempo real localmente, mientras se integra con los sistemas superiores para el entrenamiento y la optimización de toda la flota.
Componentes principales
- 4–32 nodos GPU/CPU para inferencia + análisis
- Almacenamiento local de alto rendimiento (búferes de visión, características, retención corta)
- Un tejido de escalado horizontal dedicado para el tráfico este-oeste (donde vive la mayor parte del dolor)
- Conectividad segura norte-sur con la red de la planta y los servicios centrales
Dónde se sitúa CN5000:
- As the east-west fabric between compute and storage to keep latency predictable under mixed load
- Proporcionar telemetría y análisis de tráfico para detectar congestión y optimizar el rendimiento antes de que los operadores noten desviaciones
Dónde ayuda Hammer:
- Diseños validados liderados por el partner e integración de rack para que cada despliegue de pod sea repetible en todos los sitios
La gran victoria: esta arquitectura escala operativamente. Una vez que puedes desplegar Pod v1 limpiamente, puedes replicarlo en todas las plantas con muchas menos incógnitas.
Operacionalizar el rendimiento con telemetría (porque las fábricas no tienen tiempo para conjeturas)
Los problemas de red en la fabricación rara vez llegan de forma educada. Llegan como:
- fallos intermitentes de inspección
- retrasos de inferencia inexplicables
- una línea que “se siente más lenta” después de una actualización
- trabajos de análisis nocturnos que de repente exceden la ventana de mantenimiento
Por eso el énfasis de CN5000 en la telemetría de grano fino y el análisis de tráfico en tiempo real es más que una buena característica: es un habilitador de operaciones. Cornelis describe explícitamente la telemetría/análisis utilizados para detectar congestión y optimizar el rendimiento en grandes cantidades de endpoints.
En términos prácticos, la telemetría respalda:
- Aislamiento más rápido de la causa raíz (¿cómputo, almacenamiento o tejido?)
- Ajuste proactivo (detectar enlaces y patrones problemáticos temprano)
- Escalado más seguro (añadir cámaras/nodos con evidencia, no con esperanza)
Y debido a que Hammer admite la entrega e integración de socios, puede incorporar esas expectativas operativas en la implementación desde el primer día en lugar de adaptar la observabilidad después del primer susto de producción.
Cierre: tratar la red como arquitectura de primera clase
Si habla en serio sobre acelerar la fabricación inteligente en toda Europa, trate la red como una parte de primera clase de la arquitectura.
Cornelis CN5000 aporta una estructura diseñada y comercializada para un rendimiento de escalado sin pérdidas y sin congestión, con enrutamiento adaptativo y visibilidad profunda.
Hammer ayuda a que esa capacidad sea desplegable a través del canal europeo: repetible, soportable y construida para el crecimiento.
Preguntas frecuentes: Cornelis CN5000 en la fabricación inteligente
¿Para qué se utiliza Cornelis CN5000 en la fabricación inteligente?
El CN5000 se utiliza como interconexión este–oeste dentro de un “AI pod” de fábrica; la estructura de alta velocidad entre los nodos de cómputo (GPU/CPU), el almacenamiento local y los servicios de análisis. En la fabricación inteligente, ese tráfico interno es donde chocan los flujos de visión, la extracción de características y la simulación/análisis, y donde la congestión aparece primero a medida que se escalan cámaras, líneas y canalizaciones. El objetivo es una latencia y un rendimiento predecibles bajo carga, no solo un alto ancho de banda máximo.
¿Por qué las cargas de trabajo de IA en fábricas causan congestión de red y fluctuación?
Los datos de fábrica tienden a ser de alta velocidad, ráfagas y sincronizados:
- Múltiples flujos de visión pueden llegar a la inferencia y al almacenamiento al mismo tiempo.
- “Incast” moments happen when many devices report together (alarms, end-of-cycle events, batch completions).
- Obtienes rendimiento sostenido más micro ráfagas, lo que aumenta la presión en la cola.
En redes de mejor esfuerzo, eso a menudo se convierte en acumulación de colas, pérdida de paquetes y retransmisiones, que es exactamente cómo aparecen los picos de latencia de cola, generalmente justo cuando agrega “solo una más” cámara, línea o tubería.
¿En qué se diferencia CN5000 de los diseños de “Ethernet sin pérdidas” como RoCEv2?
En muchos entornos RoCEv2, el comportamiento de “Ethernet sin pérdidas” se logra diseñando la ruta Ethernet (comúnmente con PFC + ECN/DCQCN) y ajustándola de extremo a extremo.
CN5000 se posiciona típicamente como un enfoque diferente: control de flujo basado en créditos y gestión de congestión a nivel de tejido (además de enrutamiento adaptativo) para evitar que las pérdidas y la congestión se acumulen.
La diferencia práctica es dónde reside la complejidad operativa:
- RoCEv2: más en disciplina de configuración/ajuste de Ethernet
- CN5000: más en diseño de tejido + política, con menos dependencia de los controles de “Ethernet sin pérdidas”
¿Cuándo elegiría un fabricante CN5000 Omni-Path en lugar de InfiniBand?
Ambos apuntan a un comportamiento predecible y de baja fluctuación para el cómputo escalable. La decisión generalmente se reduce al ecosistema y las operaciones:
- Elija la opción que mejor se adapte a su cadena de herramientas, habilidades, modelo de soporte y realidad de adquisición existentes.
- Use una lente de “pod”: si su clúster perimetral se comporta como un entorno de IA/HPC en miniatura y le importa sobre todo la escalabilidad estable bajo cargas de trabajo mixtas, compárelos con patrones reales de fábrica con mucha carga colectiva y ráfagas, no solo con puntos de referencia de laboratorio limpios.
¿Cómo ayudan la telemetría y el análisis de tráfico a las operaciones en el borde de la fábrica?
Los problemas de red de fábrica rara vez se presentan como alarmas ordenadas. Aparecen como:
- fallos intermitentes de inspección
- retrasos de inferencia inexplicables
- trabajos de analítica que exceden las ventanas de mantenimiento
La telemetría de grano fino le ayuda a responder rápidamente “¿cómputo, almacenamiento o red?” y a detectar enlaces calientes, patrones de congestión o efectos de vecino ruidoso antes de que los operadores sientan la deriva del rendimiento. Eso es lo que hace que el escalado sea más seguro; se añaden cámaras/nodos con evidencia, no con suposiciones.
¿Qué papel juega Hammer Distribution en el despliegue de CN5000 en Europa?
El papel de Hammer suele ser hacer que la tela sea desplegable y repetible en lugar de “simplemente comprada”:
- diseños validados mapeados a la carga de trabajo
- construcciones de rack integradas y pruebas previas
- logística alineada con las ventanas de implementación
- patrones de soporte para incidentes reales (operaciones del día 2)
En la práctica, esto respalda la ruta común del fabricante: pod piloto → primera línea → primer sitio → repetibilidad en múltiples sitios.
¿Qué es un “pod de IA de fábrica” y dónde encaja la red?
Un pod de IA de fábrica es un clúster de borde repetible que ejecuta inferencia y análisis en tiempo real localmente, mientras se integra con el nivel superior para el entrenamiento y la optimización de la flota. Un patrón típico incluye:
- ~4–32 nodos GPU/CPU
- almacenamiento local de alto rendimiento
- una estructura dedicada este-oeste
La mayor parte del dolor de escalado vive en esa capa este–oeste, por lo que el tejido es la pieza que eliges para mantener la latencia estable bajo cargas mixtas y ráfagas.
¿Qué casos de uso de fabricación inteligente se benefician más de una red sin pérdidas y con gestión de congestión?
Casos de uso que combinan rendimiento sostenido con ráfagas y sincronización:
- Pods de inspección de visión (flujos + ráfagas de metadatos + escrituras de almacenamiento)
- Bucles de gemelo digital donde la demora convierte “operaciones” en “informes”
- Análisis escalado en muchas líneas (patrones frecuentes de incast y similares a shuffle)
El tema común: evitar la latencia de cola impulsada por retransmisiones que desestabiliza el rendimiento en tiempo real.
¿Cuáles son los signos comunes de que la red es el cuello de botella en la IA perimetral?
Síntomas que se sienten “misteriosos” en producción:
- Inspecciones intermitentes que fallan o tasas de rechazo inconsistentes
- Tiempo de inferencia desigual (mismo modelo, diferentes momentos de latencia)
- La línea “se siente más lenta” después de escalar o actualizar
- Los trabajos nocturnos/de ventana de mantenimiento superan repentinamente la ventana
Si el sistema era estable y luego se degrada después de añadir la siguiente cámara/línea/tubería, la estructura es un sospechoso frecuente, especialmente cuando el problema aparece solo bajo concurrencia máxima.
¿Quiere saber más?